Todo pull request do nosso repositório principal que fica pronto para review passa pela Hopper, o agente de review que construímos internamente, antes de qualquer pessoa olhar para ele. Ela roda no Claude Opus 5.5, e as suspeitas que ela descarta durante o próprio review vão para dois segundos revisores, um no Opus 5.5 e outro no GPT-6 Astra. Este post conta o que construir a Hopper nos ensinou, com os nossos números, e traz minhas oito apostas de como os times vão revisar código até outubro de 2027. A resposta curta é que as máquinas vão ler toda mudança, as pessoas vão assinar as que podem machucar a empresa, e o compliance vai tornar essa divisão obrigatória.
Pencils down
No mês passado, no keynote do Rails World, o DHH disse que a 37signals entrou em “pencils down” para código escrito à mão. A pessoa que passou vinte anos defendendo a felicidade do programador e o Ruby bonito está colocando agentes para reescrever o backend do HEY em Rust, uma linguagem que ele já disse ser dolorosa de ler e que agora nunca mais precisa ler. O keynote terminou em “total optimism”, e eu concordo com quase tudo. O que eu quero acrescentar é o review. Se as pessoas param de escrever o código e param de ler o código, alguma coisa precisa pegar o que dá errado, e na semana passada tivemos o melhor retrato público até agora de como essa coisa funciona.
O que a Anthropic publicou na semana passada
A Anthropic publicou como faz code review agora que o Claude escreve cerca de 90% do próprio Claude Code, num post de Addy Osmani, Morgan Westlee Lunt e Qing Wang. Eles mantiveram o review, passaram a maior parte da leitura para as máquinas e deixaram para as pessoas o que as máquinas fazem mal. Um classificador coloca cada mudança numa faixa de risco, e a faixa decide se ela precisa de zero, uma ou duas pessoas, com os caminhos mais leves liberados só para autores numa lista de confiança. Alguns caminhos, como os arquivos de workflow de CI, sempre exigem uma pessoa, e, nas palavras deles, “an agent’s approval never counts as a person’s”: a aprovação de um agente nunca conta como a de uma pessoa. Quem pediu a mudança assina como ela foi testada e como desfazê-la, e a regra do time é “you land it, you own it”: se a sua mudança quebra alguma coisa, normalmente é você quem conserta. O revisor deles roda todo dia contra pull requests antigos que causaram incidentes, e depois de três rodadas sem convergir ele pede para o autor dar um passo atrás e repensar a abordagem, uma regra que existe porque um pull request passou por mais de cinquenta rodadas numa noite.
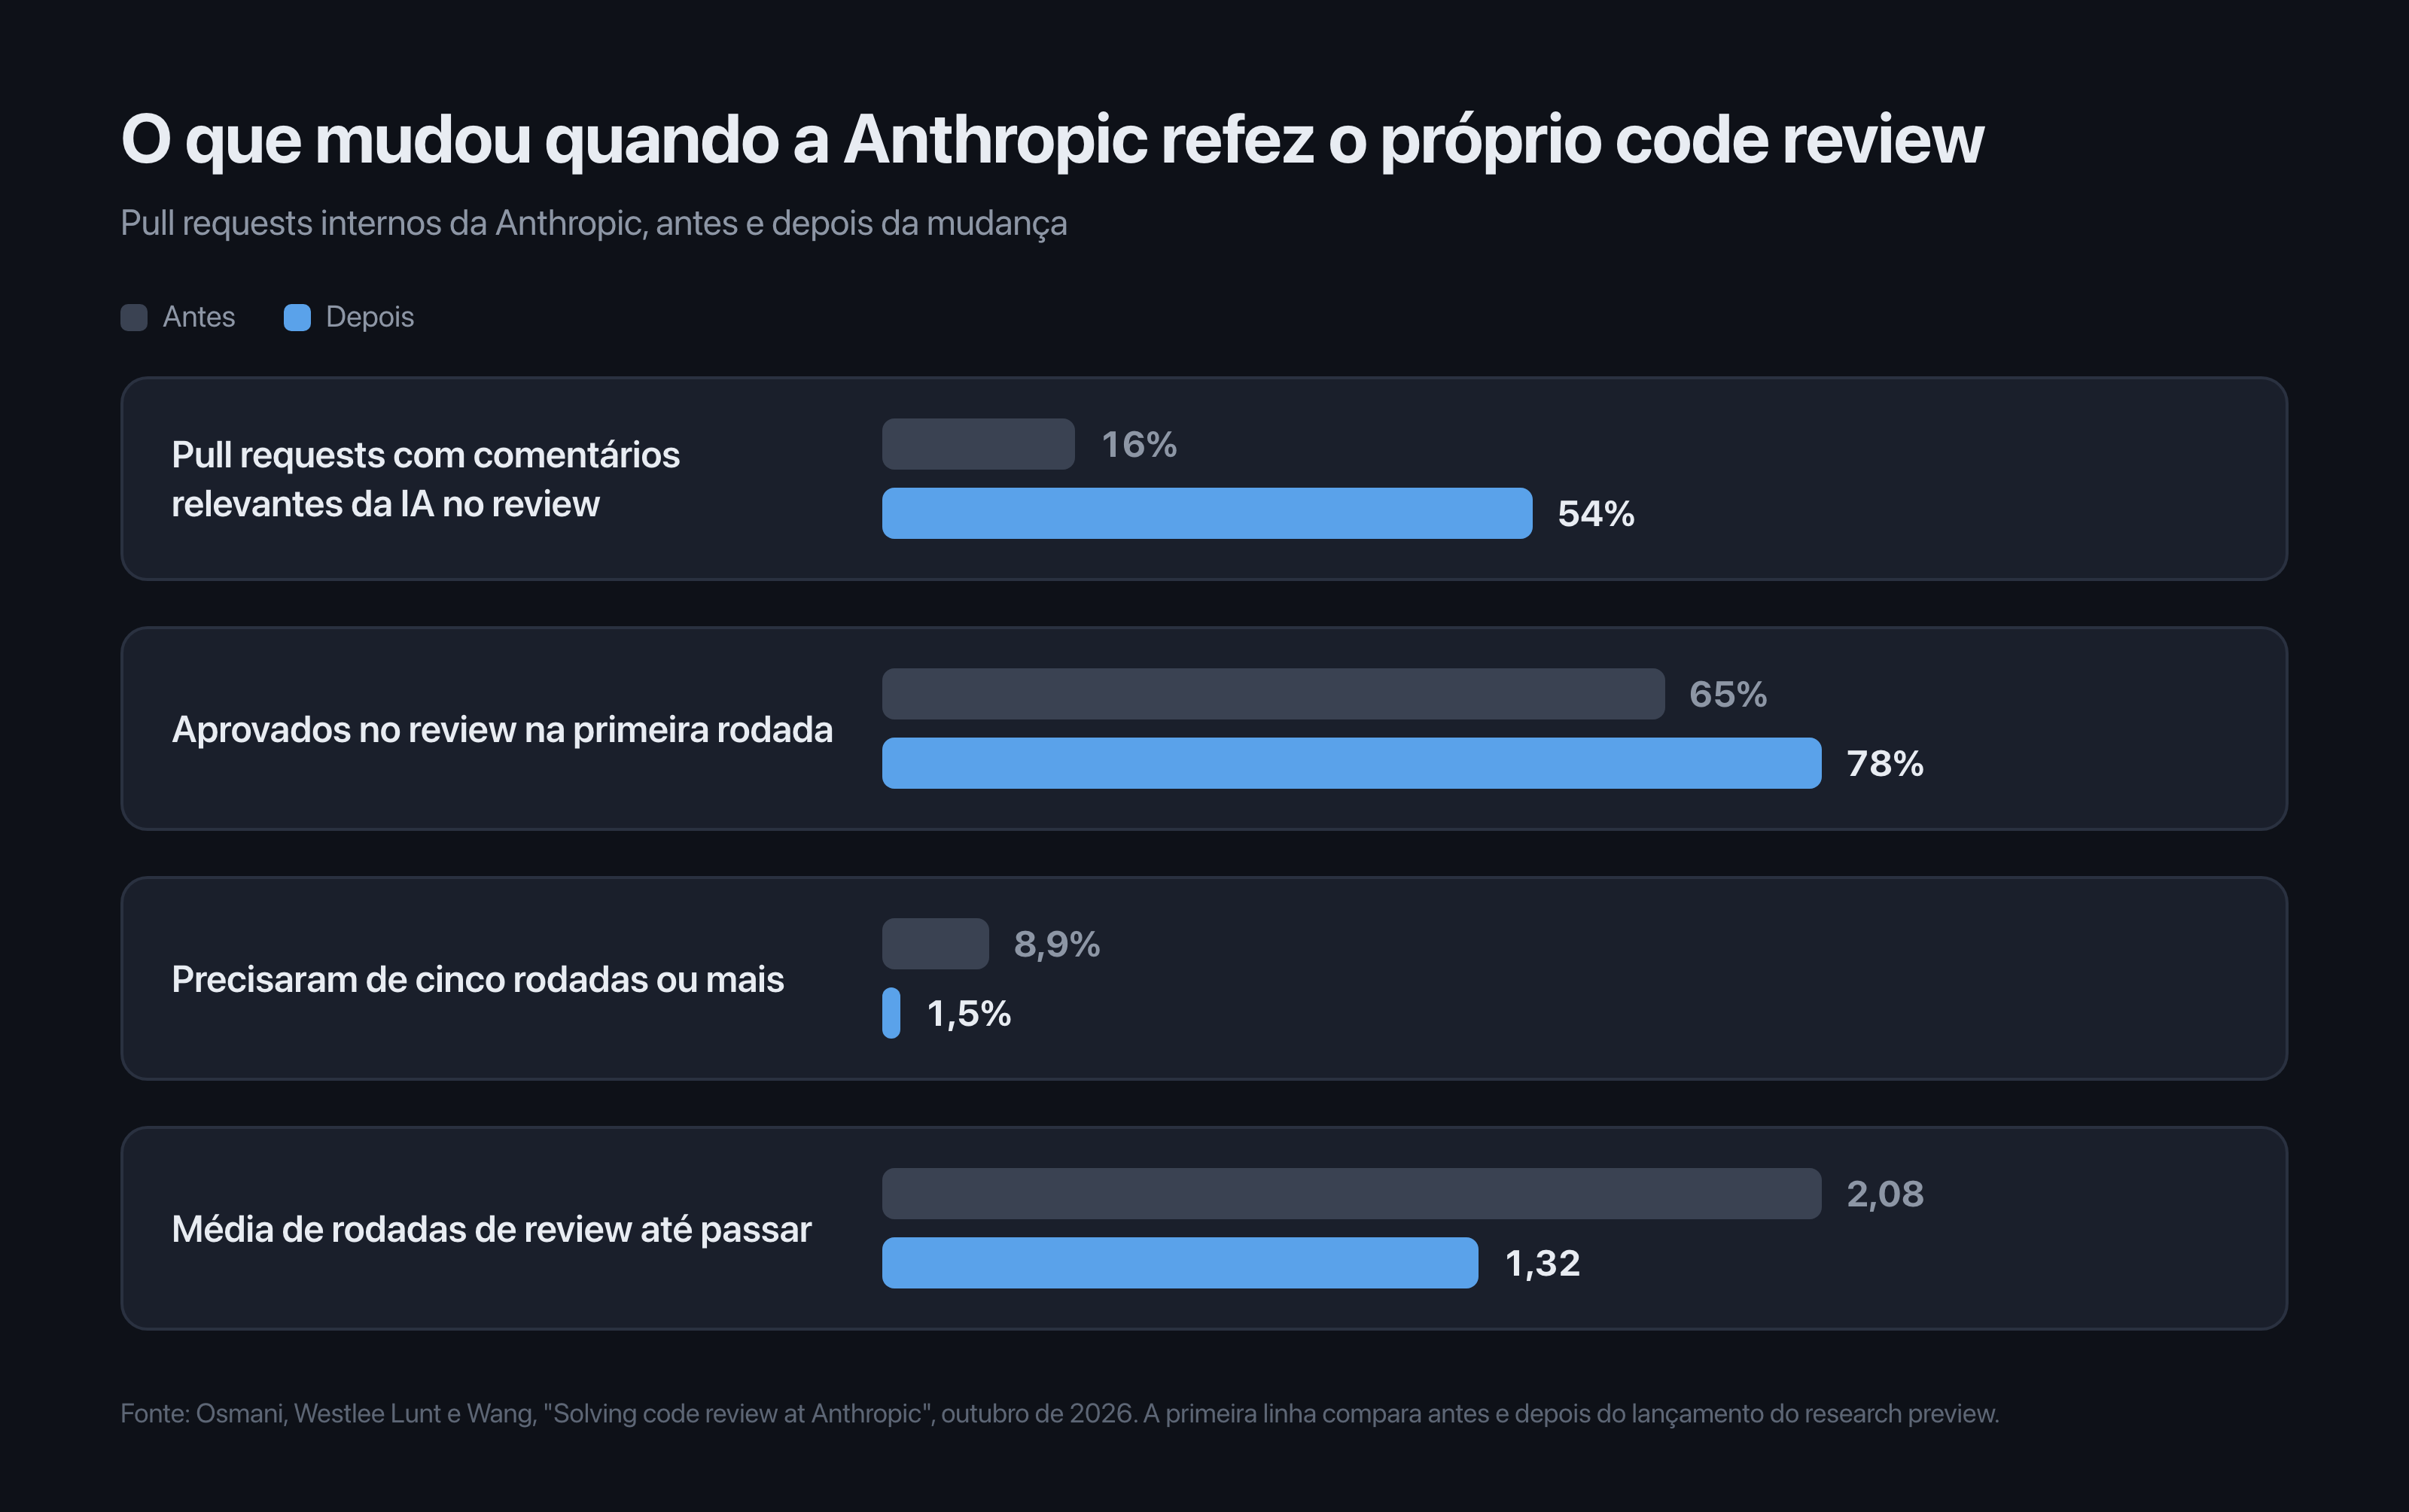
Entre junho e setembro, os pull requests com merge no Claude Code mais que dobraram, enquanto a parcela que precisou de revert caiu mais de 40%, e foi isso que me fez escrever este post. O review também converge mais rápido: depois que eles o refizeram, a parcela de pull requests que precisavam de cinco rodadas ou mais caiu de 8,9% para 1,5%.
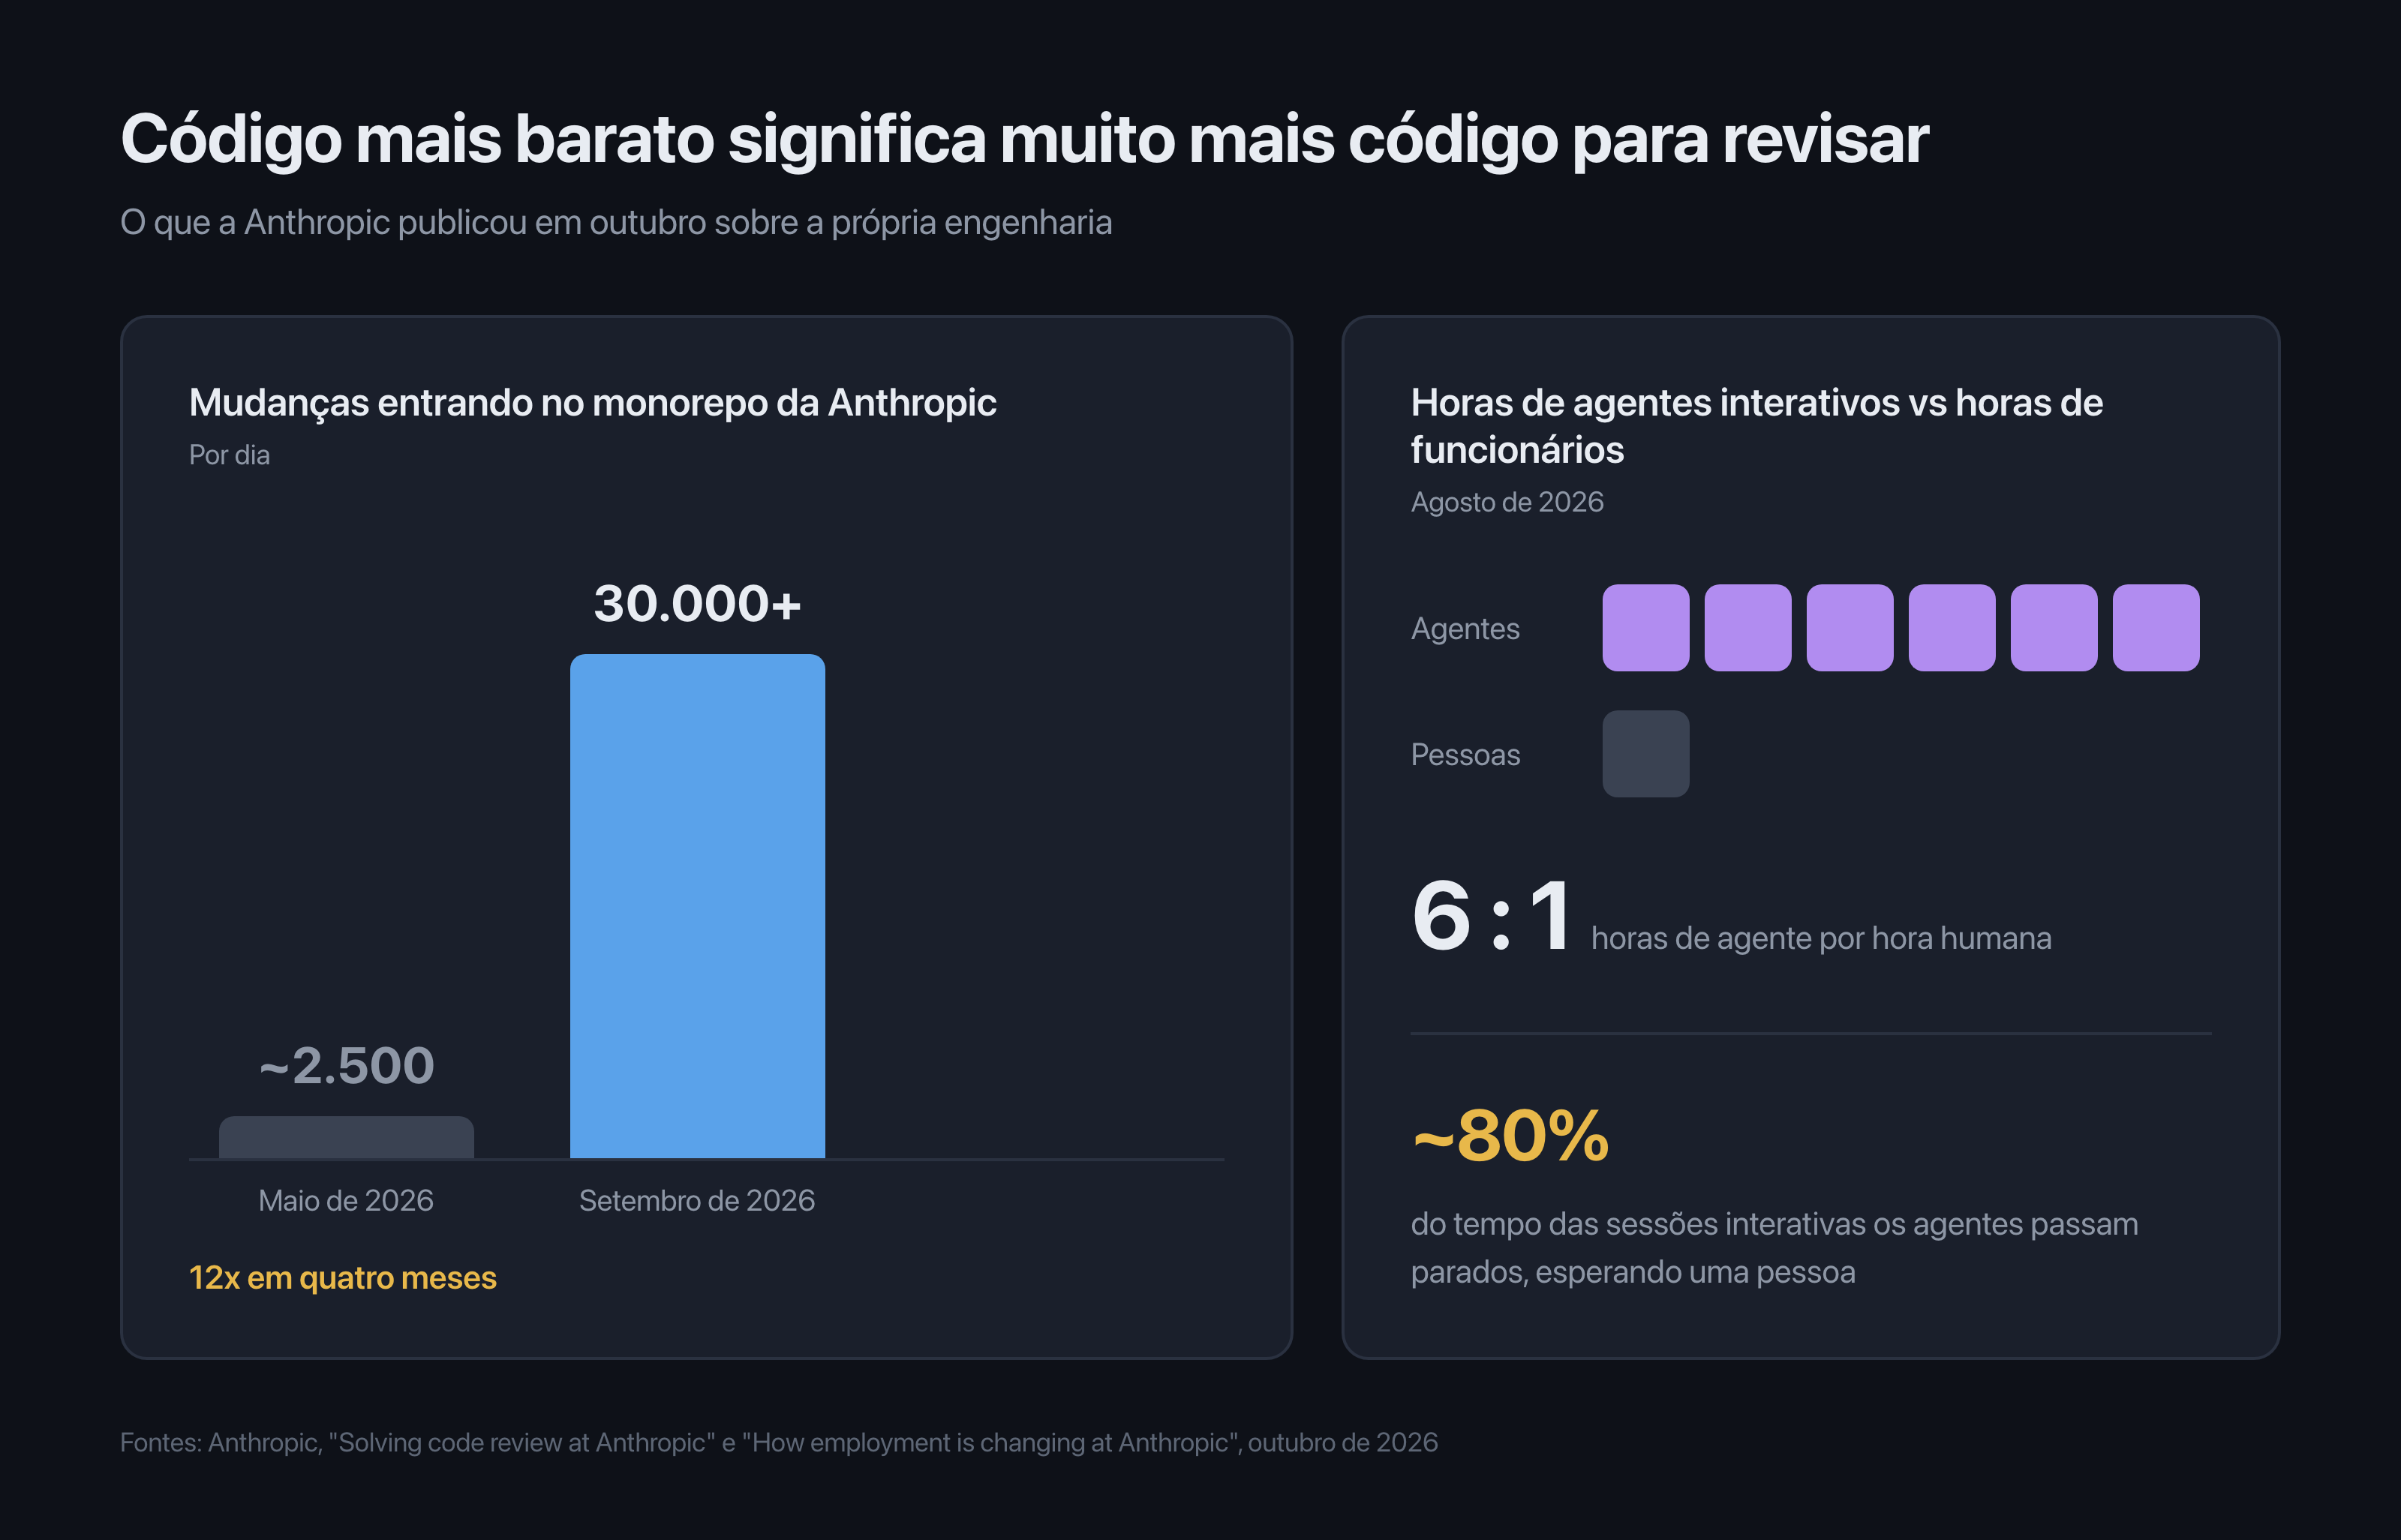
As mudanças entrando no monorepo da Anthropic foram de cerca de 2.500 por dia em maio para mais de 30.000 em setembro. Na mesma semana do post sobre review, o Code Review ficou disponível para todos nos planos Team e Enterprise, e o relatório da Anthropic sobre a própria força de trabalho mostrou que as horas de agentes já superam as horas dos funcionários em seis para um, e que cerca de 80% do tempo das sessões interativas os agentes passam esperando uma pessoa. Acho que boa parte dessa espera é review: escrever código ficou barato, e as pessoas que leem e aprovam o código não ficaram nem um pouco mais rápidas.
O que as pesquisas dizem sobre código escrito por IA
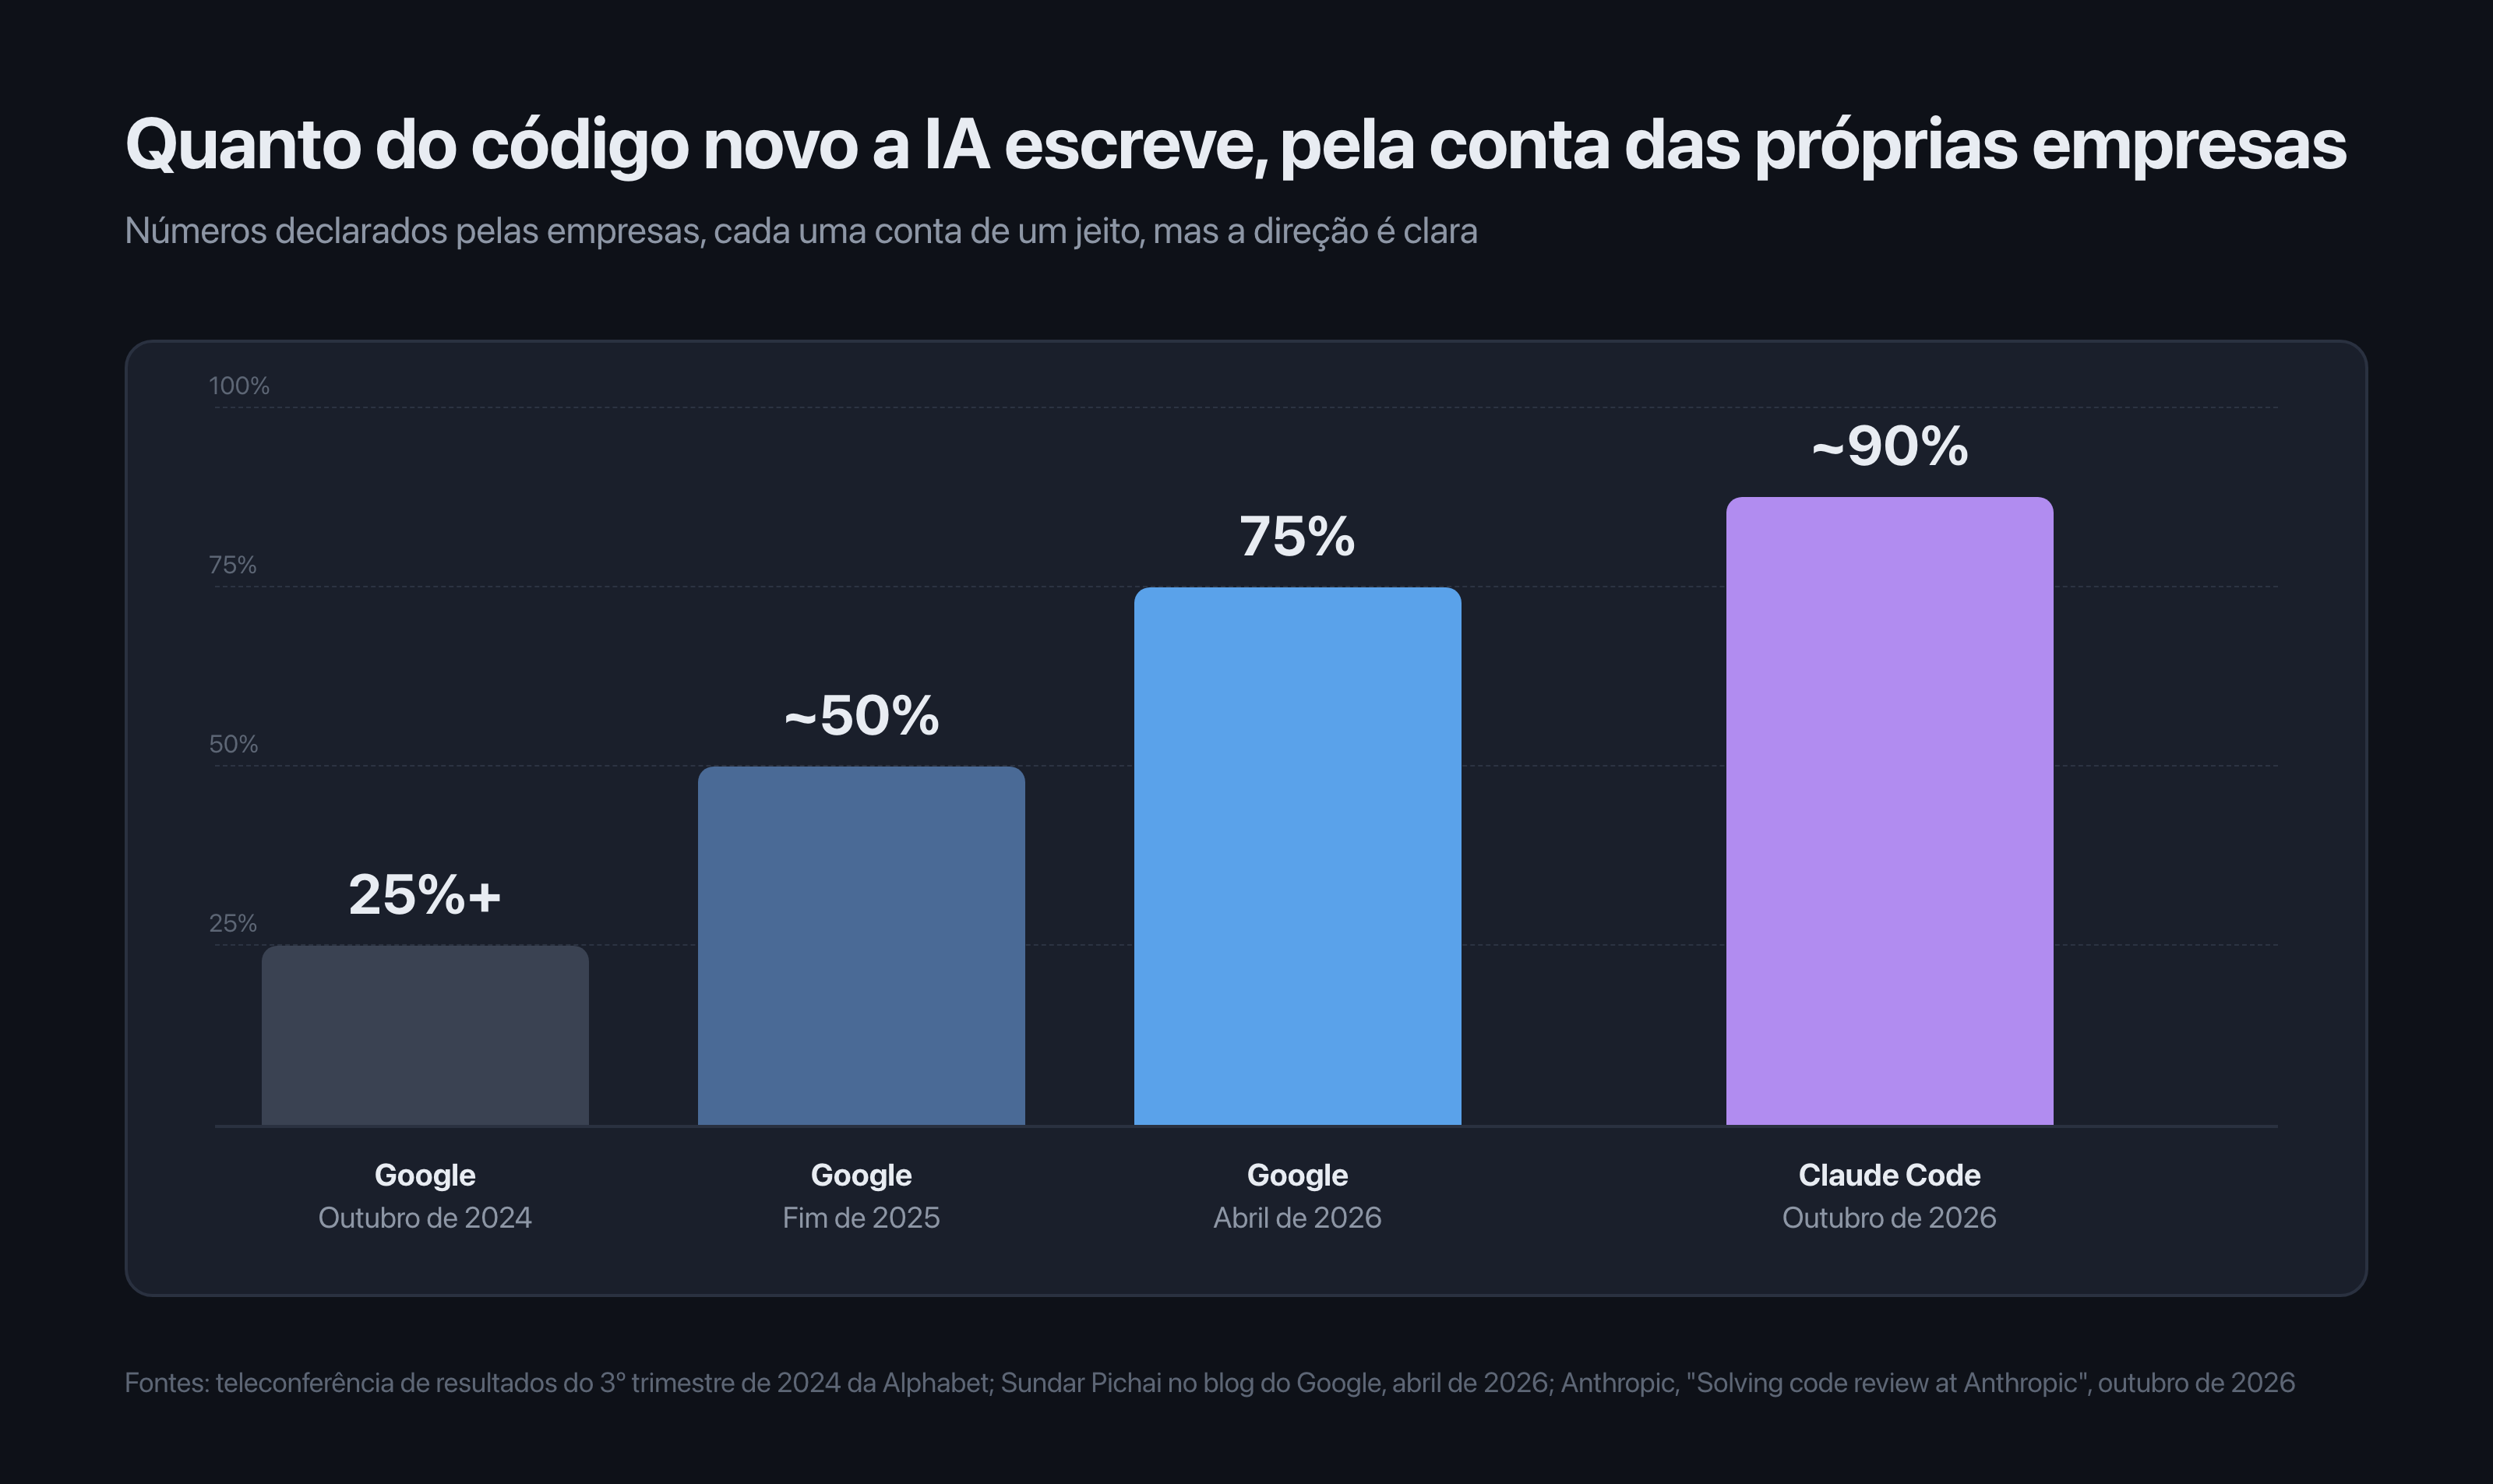
O Sundar Pichai escreveu em abril que 75% de todo código novo no Google é gerado por IA e aprovado por engenheiros, contra 50% no fim do ano anterior e pouco mais de um quarto no fim de 2024. Cada empresa faz essa conta de um jeito, então os números exatos importam menos que a direção.
Sobre qualidade, as pesquisas não concordam. A pesquisa DORA do Google mostrou que mais adoção de IA vem junto com mais throughput e também com mais instabilidade. A CodeRabbit analisou 470 pull requests open source e encontrou cerca de 1,7 vez mais problemas nos que foram escritos com IA, mas são dados de uma empresa que vende review. O relatório da Anthropic comparou as mesmas pessoas, no mesmo mês e no mesmo diretório, e não encontrou diferença em quantas vezes o código escrito por agentes foi removido ou revertido depois. Minha leitura é que as três coisas podem ser verdade ao mesmo tempo. O código escrito por IA é mais ou menos tão bom quanto o sistema de review em volta dele, e a maioria dos times ainda usa um processo de review pensado para poucas mudanças por dia escritas por pessoas.
Uma correção pequena, dezesseis achados
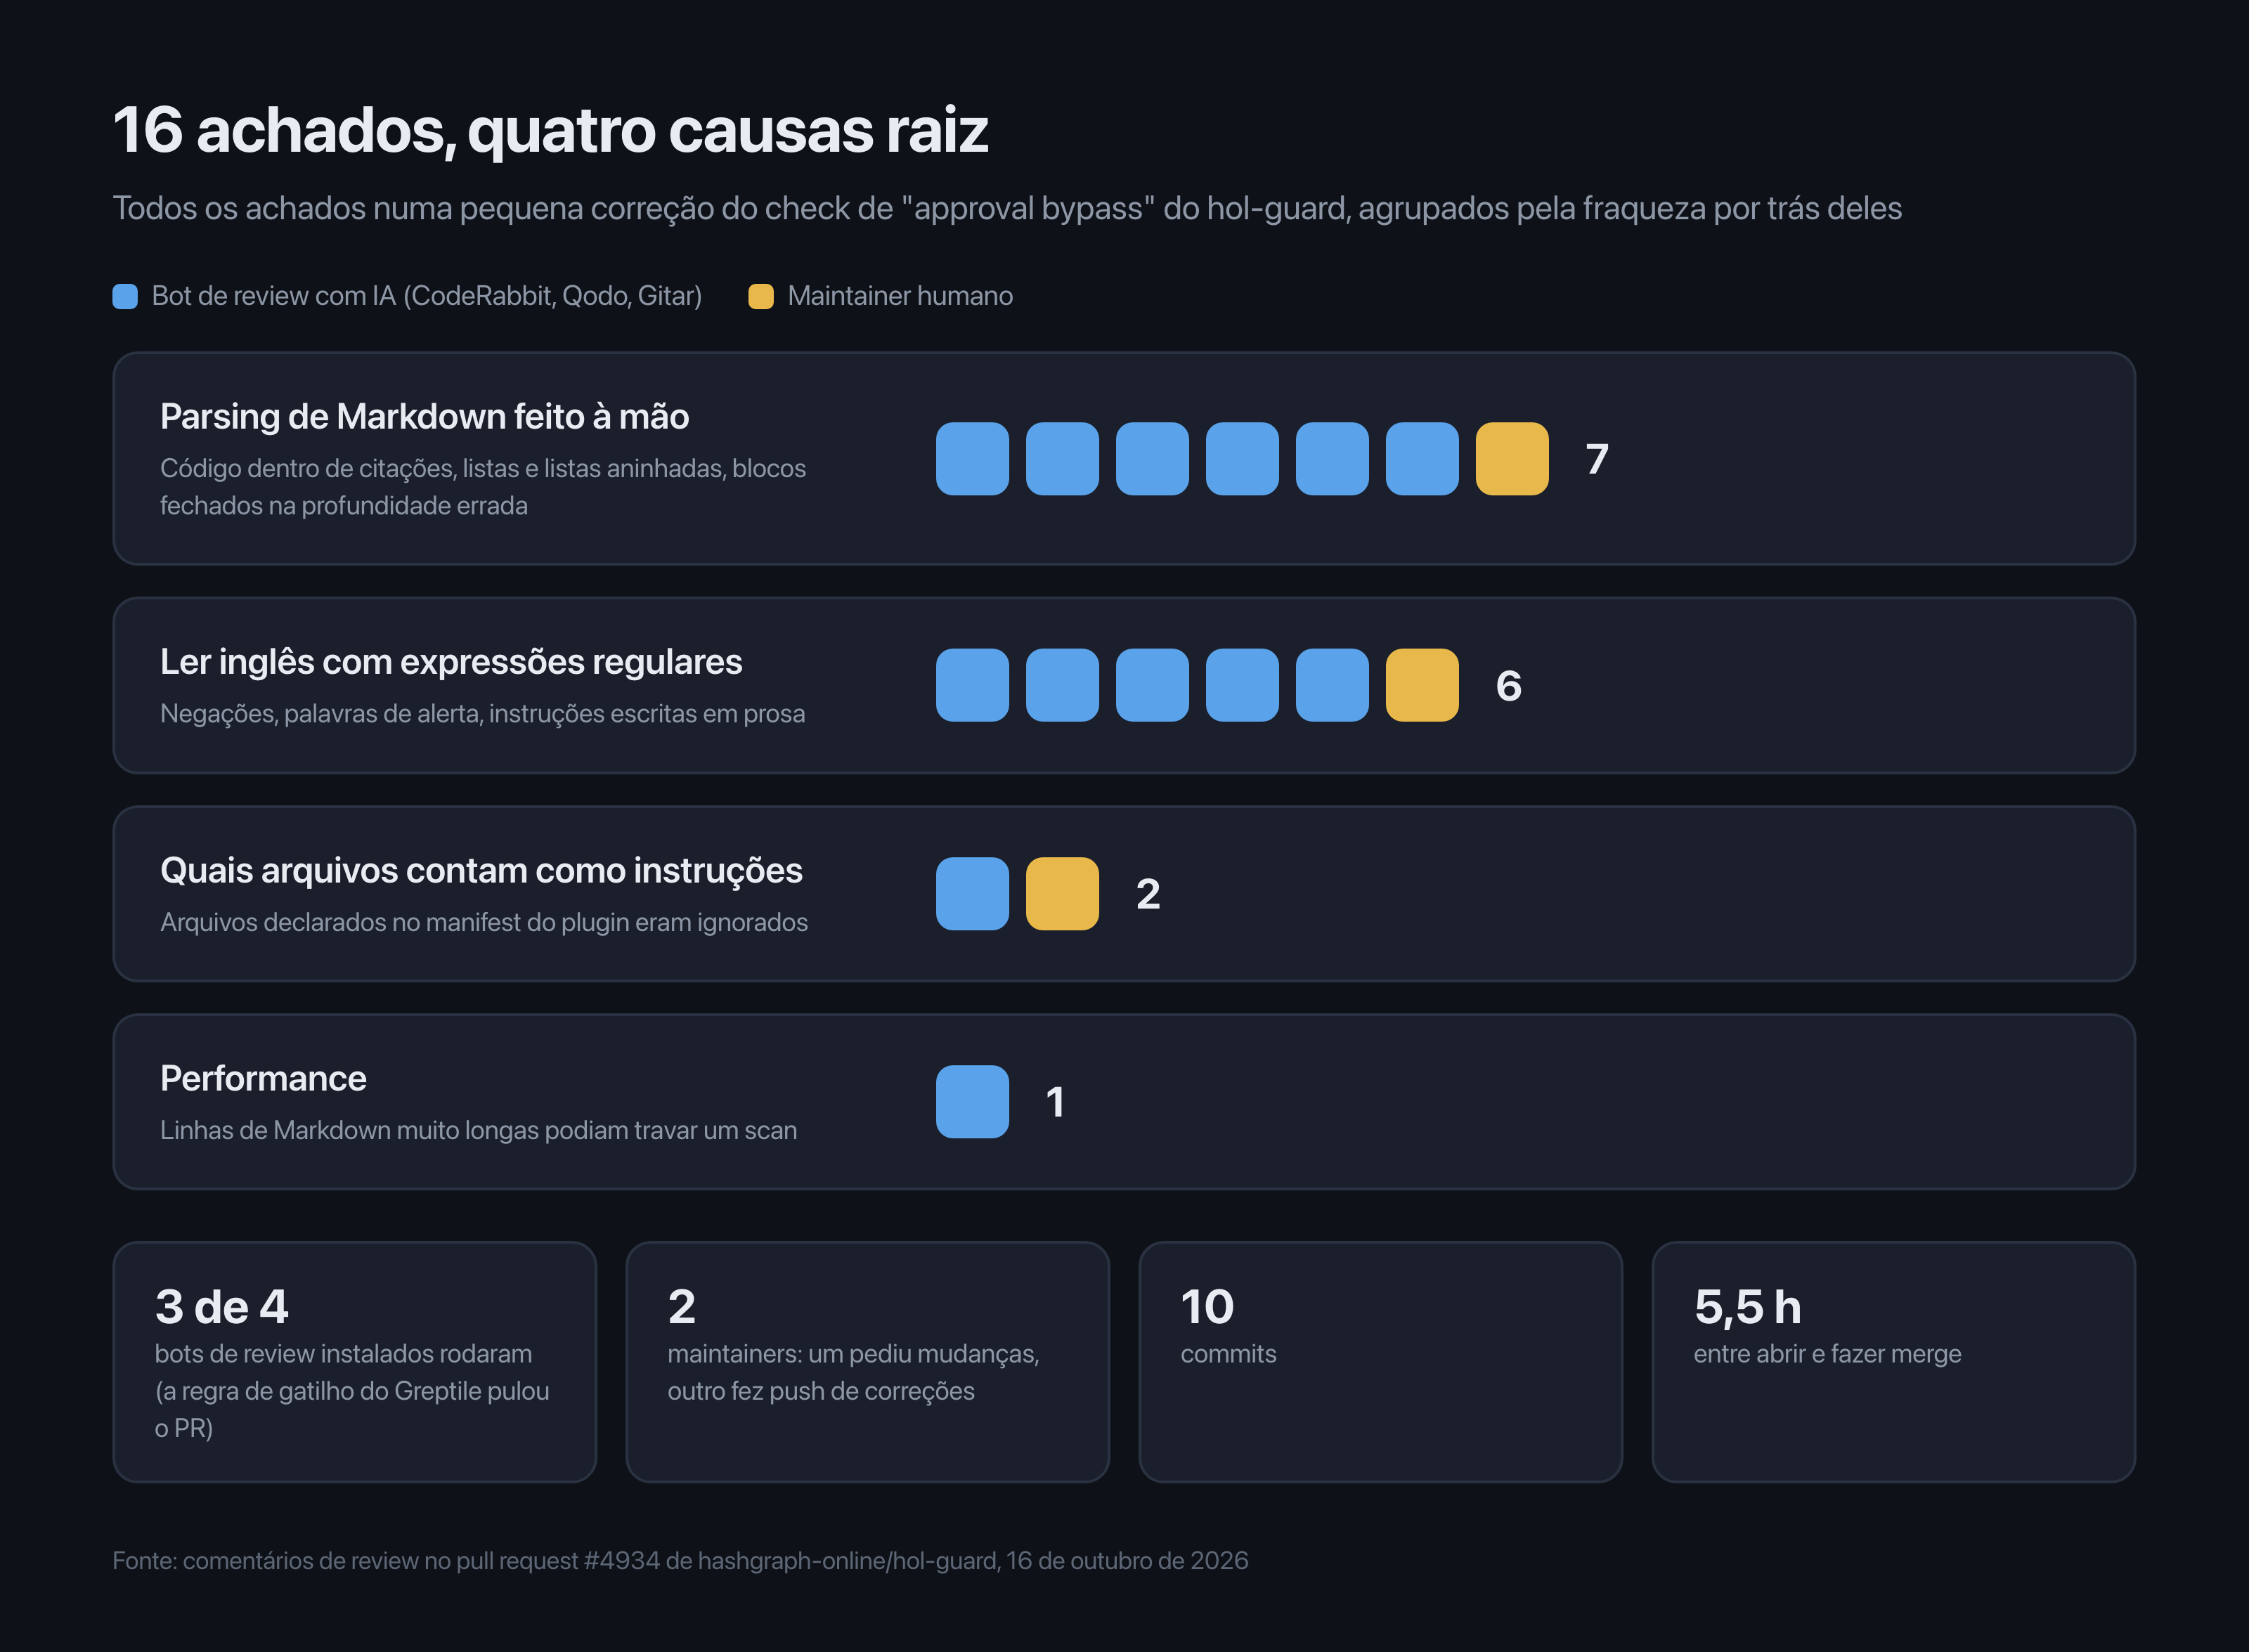
Na sexta passada mandei uma correção pequena para o hol-guard, um scanner open source para plugins de IA. O check de “approval bypass” estava acusando documentação que só mencionava uma configuração arriscada de sandbox do Codex, e a minha mudança ensinou o scanner a separar uma menção de uma instrução. O repositório tem quatro bots de review com IA instalados. Três revisaram o PR (CodeRabbit, Qodo e Gitar), e a regra de gatilho do Greptile pulou o PR. Dois maintainers também revisaram: um pediu mudanças com três falsos negativos que tinha reproduzido, e o outro fez push de correções direto na minha branch. Foram 10 commits, e o merge saiu cinco horas e meia depois que eu abri o PR.
Os bots foram rápidos e acertaram quase sempre. Contei dezesseis achados, e quinze deles eram novos casos de três fraquezas: parsing de Markdown feito à mão (código dentro de uma citação, de uma lista ou de uma lista aninhada, blocos fechados na profundidade errada), ler inglês com expressões regulares (negações, palavras de alerta, passos de configuração escritos em prosa) e quais arquivos contam como instruções. Corrigi um de cada vez. O resumo de um dos bots ainda terminou com um selo verde de “Approved”, exatamente o tipo de sinal que a regra da Anthropic se recusa a contar. Ou seja, numa correção pequena, três bots leram a mudança e dois maintainers decidiram, e juntos pegamos cada caso sem que ninguém, bot ou pessoa, desse nome às fraquezas por trás deles.
O que aprendemos construindo nosso próprio revisor
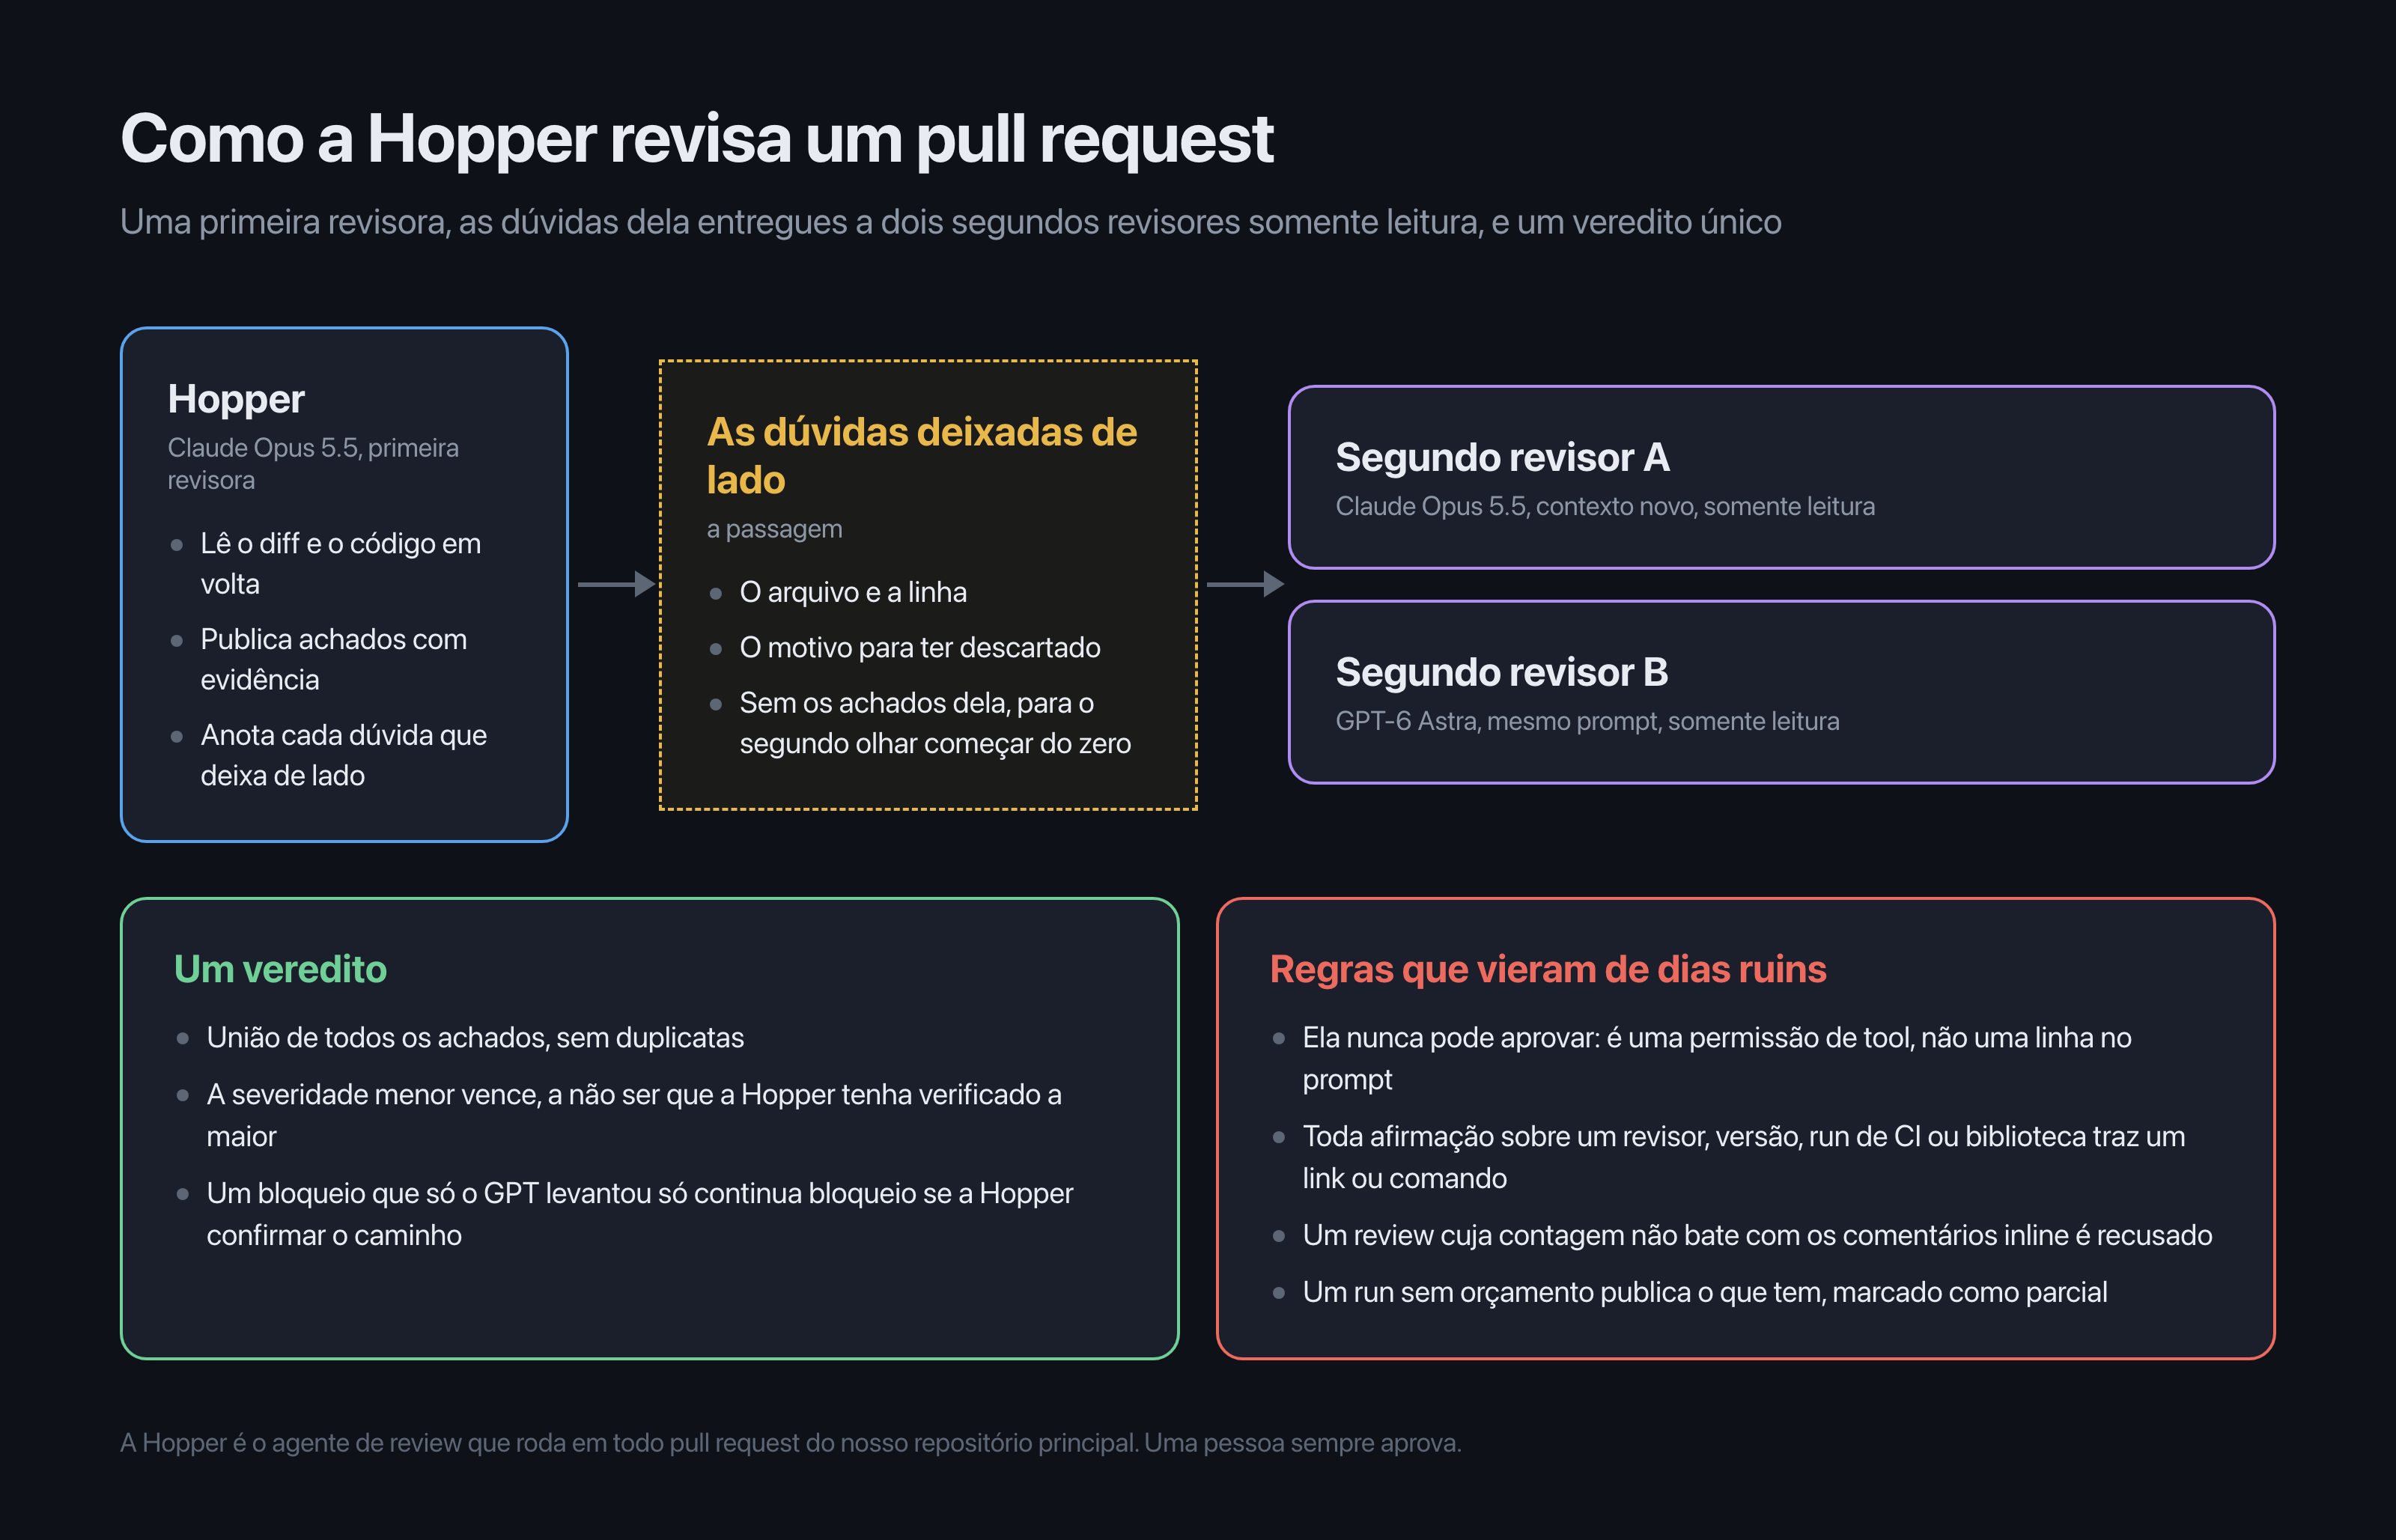
A Hopper roda em todo pull request do nosso repositório principal que fica pronto para review, e uma pessoa ainda aprova cada merge. É assim que ela funciona hoje:
Os erros são dúvidas que ela mesma descartou. Quando olhamos os defeitos que a Hopper deixou passar, cerca de metade eram coisas que ela tinha notado no próprio raciocínio e depois descartado como menores ou já tratadas: 13 de 24 na amostra que checamos. Um prompt mandando ela terminar o que começa não mudou nada. O que funcionou foi entregar essas dúvidas descartadas, com o arquivo e o motivo de ter largado cada uma, para um segundo revisor que começa com um contexto novo. Das dúvidas que sobrevivem a esse segundo olhar, 27 de 30 eram problemas reais.
Uma segunda família de modelos acha bugs diferentes. Os dois segundos revisores recebem o mesmo prompt de propósito, para que a única coisa que muda seja o modelo. Em 19 casos reproduzidos, o revisor GPT achou 16 defeitos reais que o revisor Claude não viu, o Claude achou 4 que o GPT não viu, e nenhum dos dois levantou um achado de correção que estivesse errado. Os achados extras do GPT puxavam para race conditions e lógica invertida, como um filtro em que “menor que 5” rejeitava o 4, ou duas primeiras mensagens simultâneas criando duas conversas separadas. Os do Claude puxavam para dados de UI que ficam desatualizados depois de uma edição. O GPT também exagerou a severidade em 6 dos seus 21 achados bloqueantes, contra 0 de 6 do Claude. Por isso o veredito final junta os achados dos dois revisores. Quando eles discordam sobre a severidade, vence a menor, a não ser que a Hopper tenha verificado a maior, e um achado bloqueante que só o GPT levantou só continua bloqueante se a Hopper confirmar o caminho ela mesma.
Medir um revisor é mais difícil que construir um. Nossos primeiros números de recall eram bons demais. Quando você reproduz um pull request antigo, o revisor consegue ler o futuro: um commit posterior com o nome da correção, ou uma descrição editada depois do review. Os runs que enxergavam o futuro acharam 68% dos defeitos, e os runs limpos acharam 44%. Hoje checamos vazamentos em todo run e pontuamos esses casos separadamente. Comparando com o que os revisores humanos levantaram, a Hopper pega cerca de 45% dos defeitos bloqueantes, mas esse número subestima o trabalho dela: numa amostra de 30 achados que ela acrescentou, 25 foram confirmados como reais, nenhum se mostrou falso, e a maioria eram bugs que nenhuma pessoa tinha comentado. Do que ela publica, 96% está correto, mas só cerca de um quarto é relevante, e os engenheiros quase nunca discordam dela.
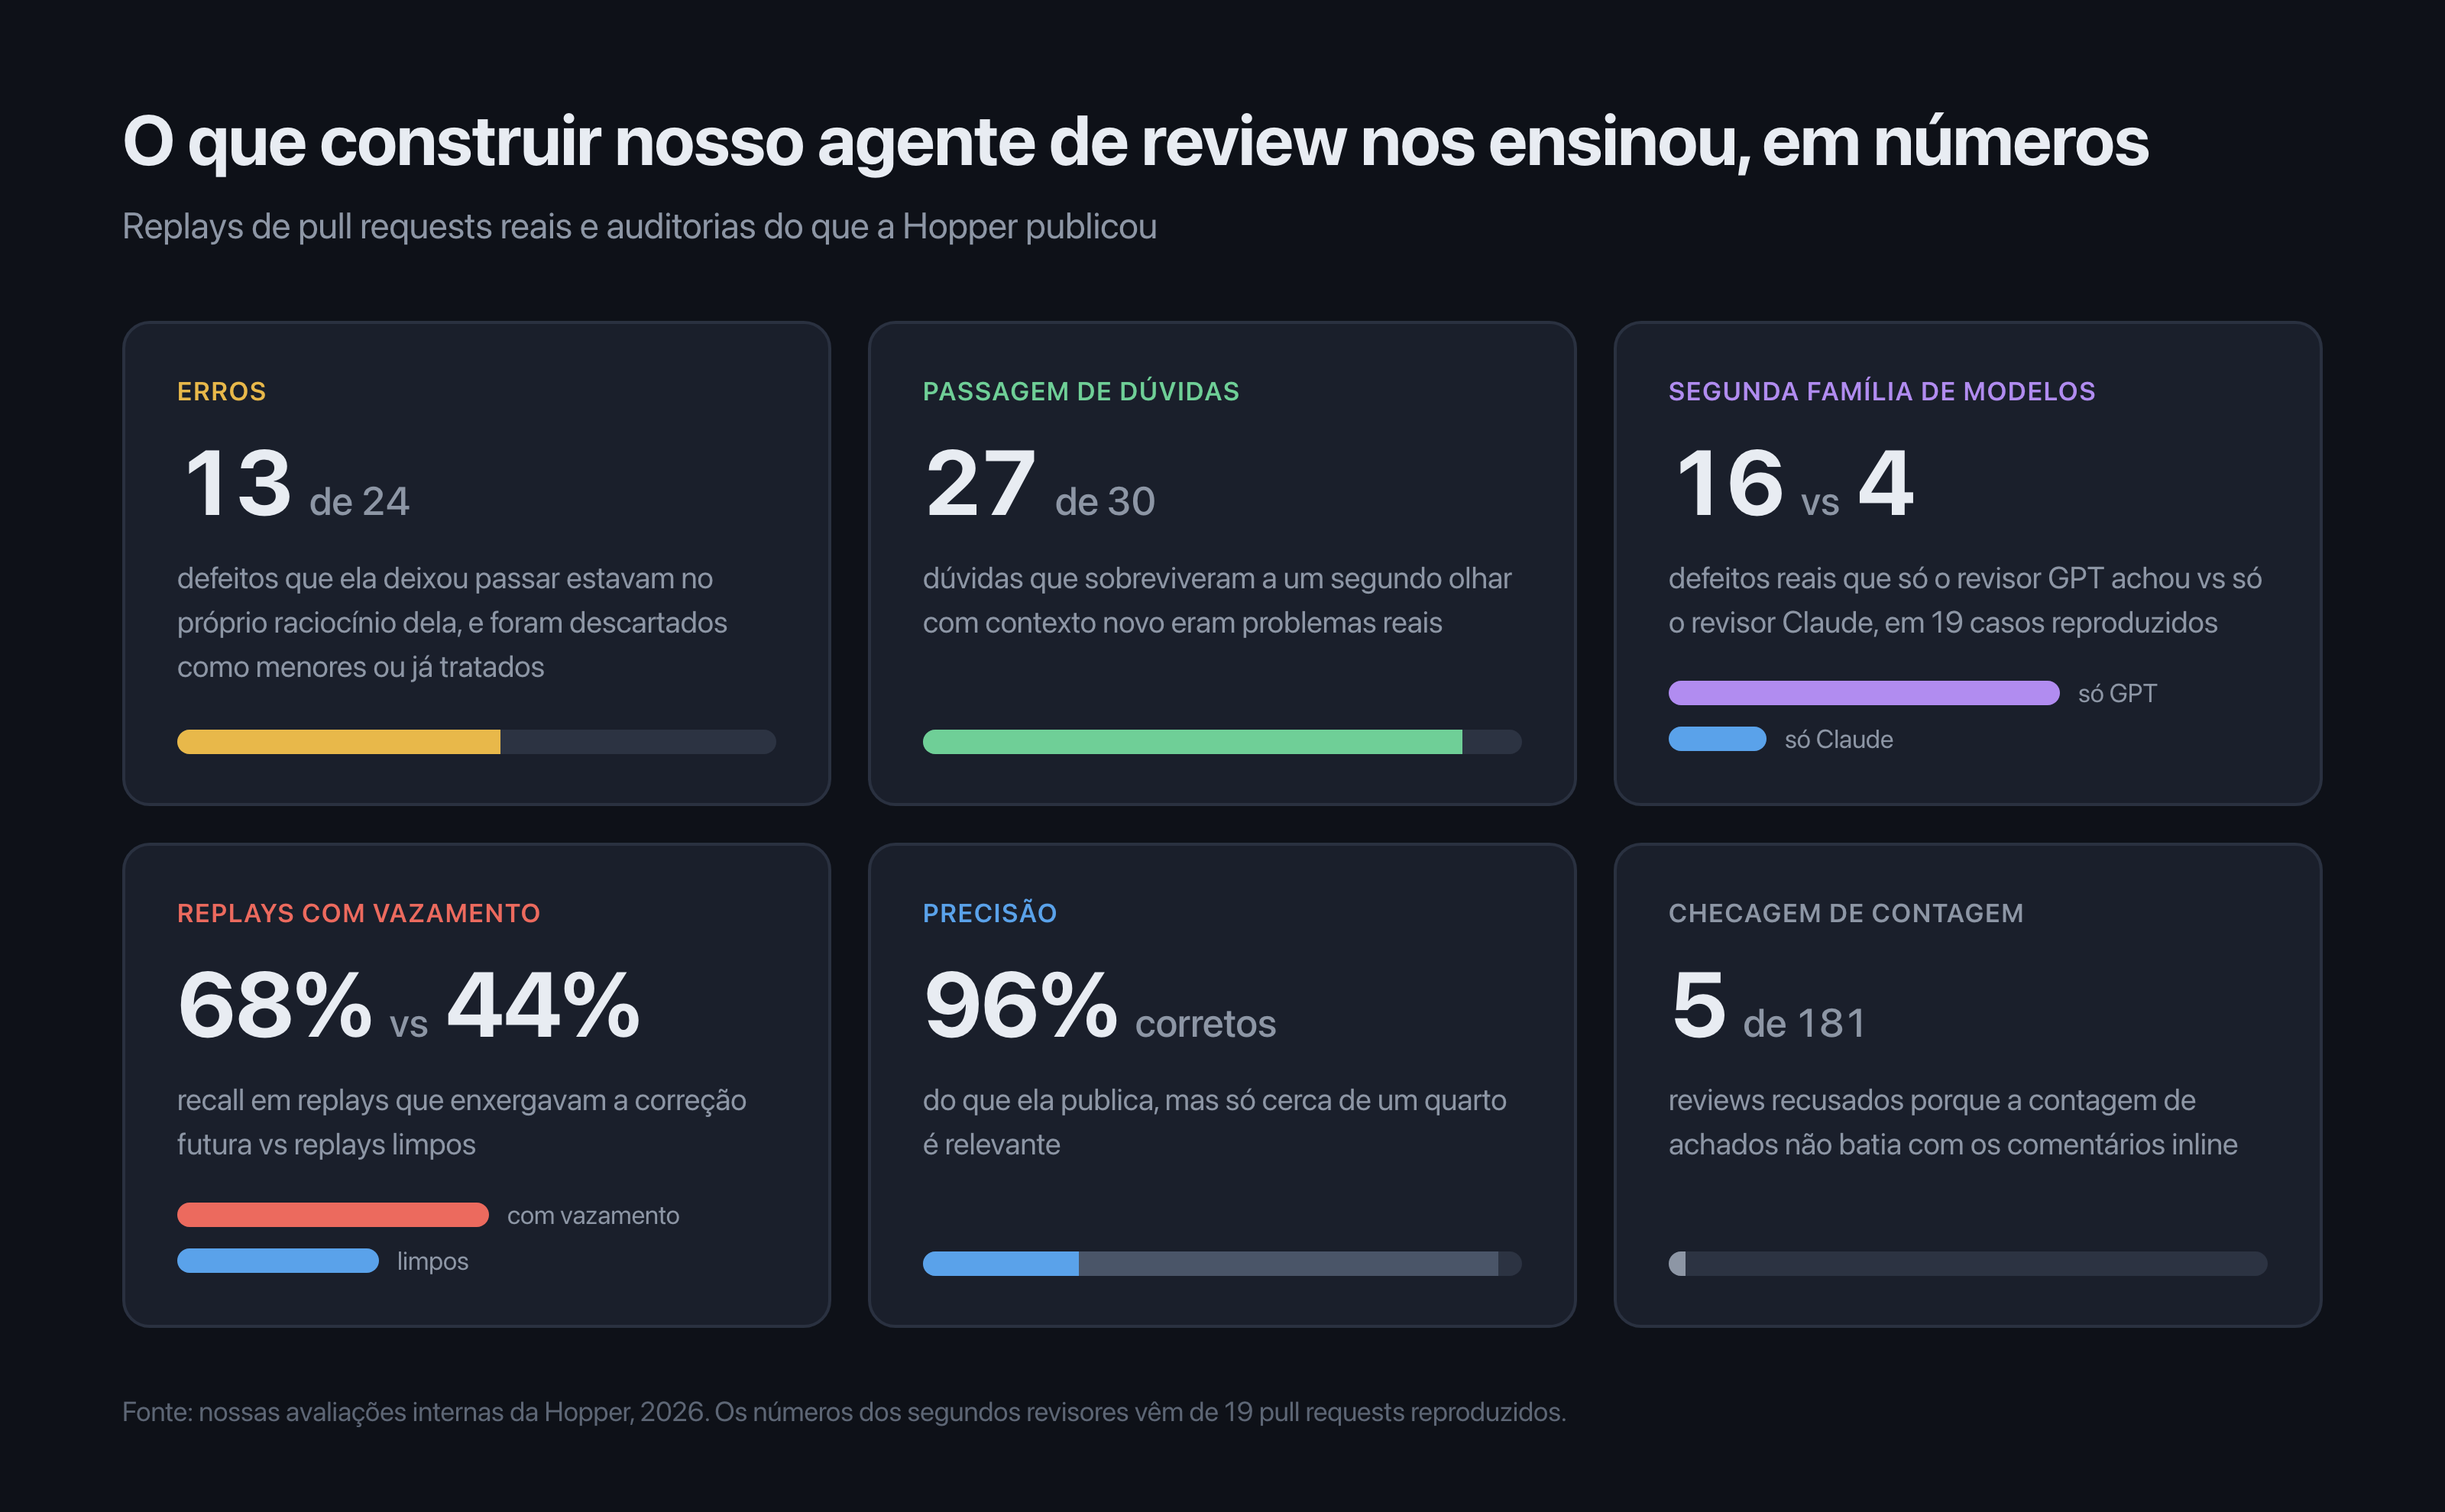
A maioria das regras dela veio de erros dela. Ela nunca aprova um pull request, e isso é garantido por uma permissão de tool, não por uma linha no prompt, porque um selo verde de um bot parece uma aprovação a mais do que realmente existe. Na primeira semana ela inventou um achado sobre um comentário de outro revisor que não existia, então hoje qualquer afirmação sobre um revisor, uma versão, um resultado de CI ou uma biblioteca precisa trazer o link ou o comando que mostrou aquilo. Os vereditos dela às vezes contavam achados cujos comentários inline nunca chegavam a ser publicados, e esses achados saíam soltos num comentário ou se perdiam. Uma checagem agora recusa qualquer review cuja contagem não bate com os comentários inline, e ela já pegou 5 deslizes reais em 181 reviews. No começo, 28% do que gastávamos com ela não publicava nada, porque os runs que estouravam o orçamento paravam no meio do raciocínio, então um run sem orçamento agora ganha um último passo em que a única ação permitida é publicar o que ela tem, marcado como parcial.
O ponto cego dela é tudo que só aparece rodando o código. Bugs de ciclo de vida e de runtime, os que aparecem quando uma sessão é atualizada no meio de um stream ou quando o usuário sai da página, ela quase nunca pega lendo, e é por isso que a minha segunda aposta abaixo é sobre um review que roda o código.
O que eu copiaria primeiro
Se você roda um agente de review ou vai construir um, estas são as partes do nosso setup que eu copiaria primeiro, mais ou menos em ordem de valor por esforço:
- Tire a permissão de aprovar das credenciais do agente, em vez de pedir no prompt que ele não aprove.
- Peça para o revisor anotar o que descartou e por quê, e entregue essas dúvidas a um segundo revisor de outra família de modelos, com contexto novo e o mesmo prompt.
- Antes de confiar num número de recall, cheque se o run reproduzido conseguia ver a correção.
- Exija que toda afirmação traga a sua evidência, um link ou um comando.
- Recuse qualquer review cujo resumo não bate com os comentários inline.
Oito apostas para outubro de 2027
É para cá que eu acho que isso vai em um ano. No fim tem um placar com o quanto eu confio em cada aposta e o que me diria que eu errei, para eu me avaliar em outubro do ano que vem.
1. As pessoas param de digitar código, e continuam donas dele. Quase ninguém num time forte vai escrever código à mão para produção. A responsabilidade não passa para a máquina, porém. “You land it, you own it” vira o padrão em todo lugar: quem pediu a mudança responde por ela no review e no postmortem.
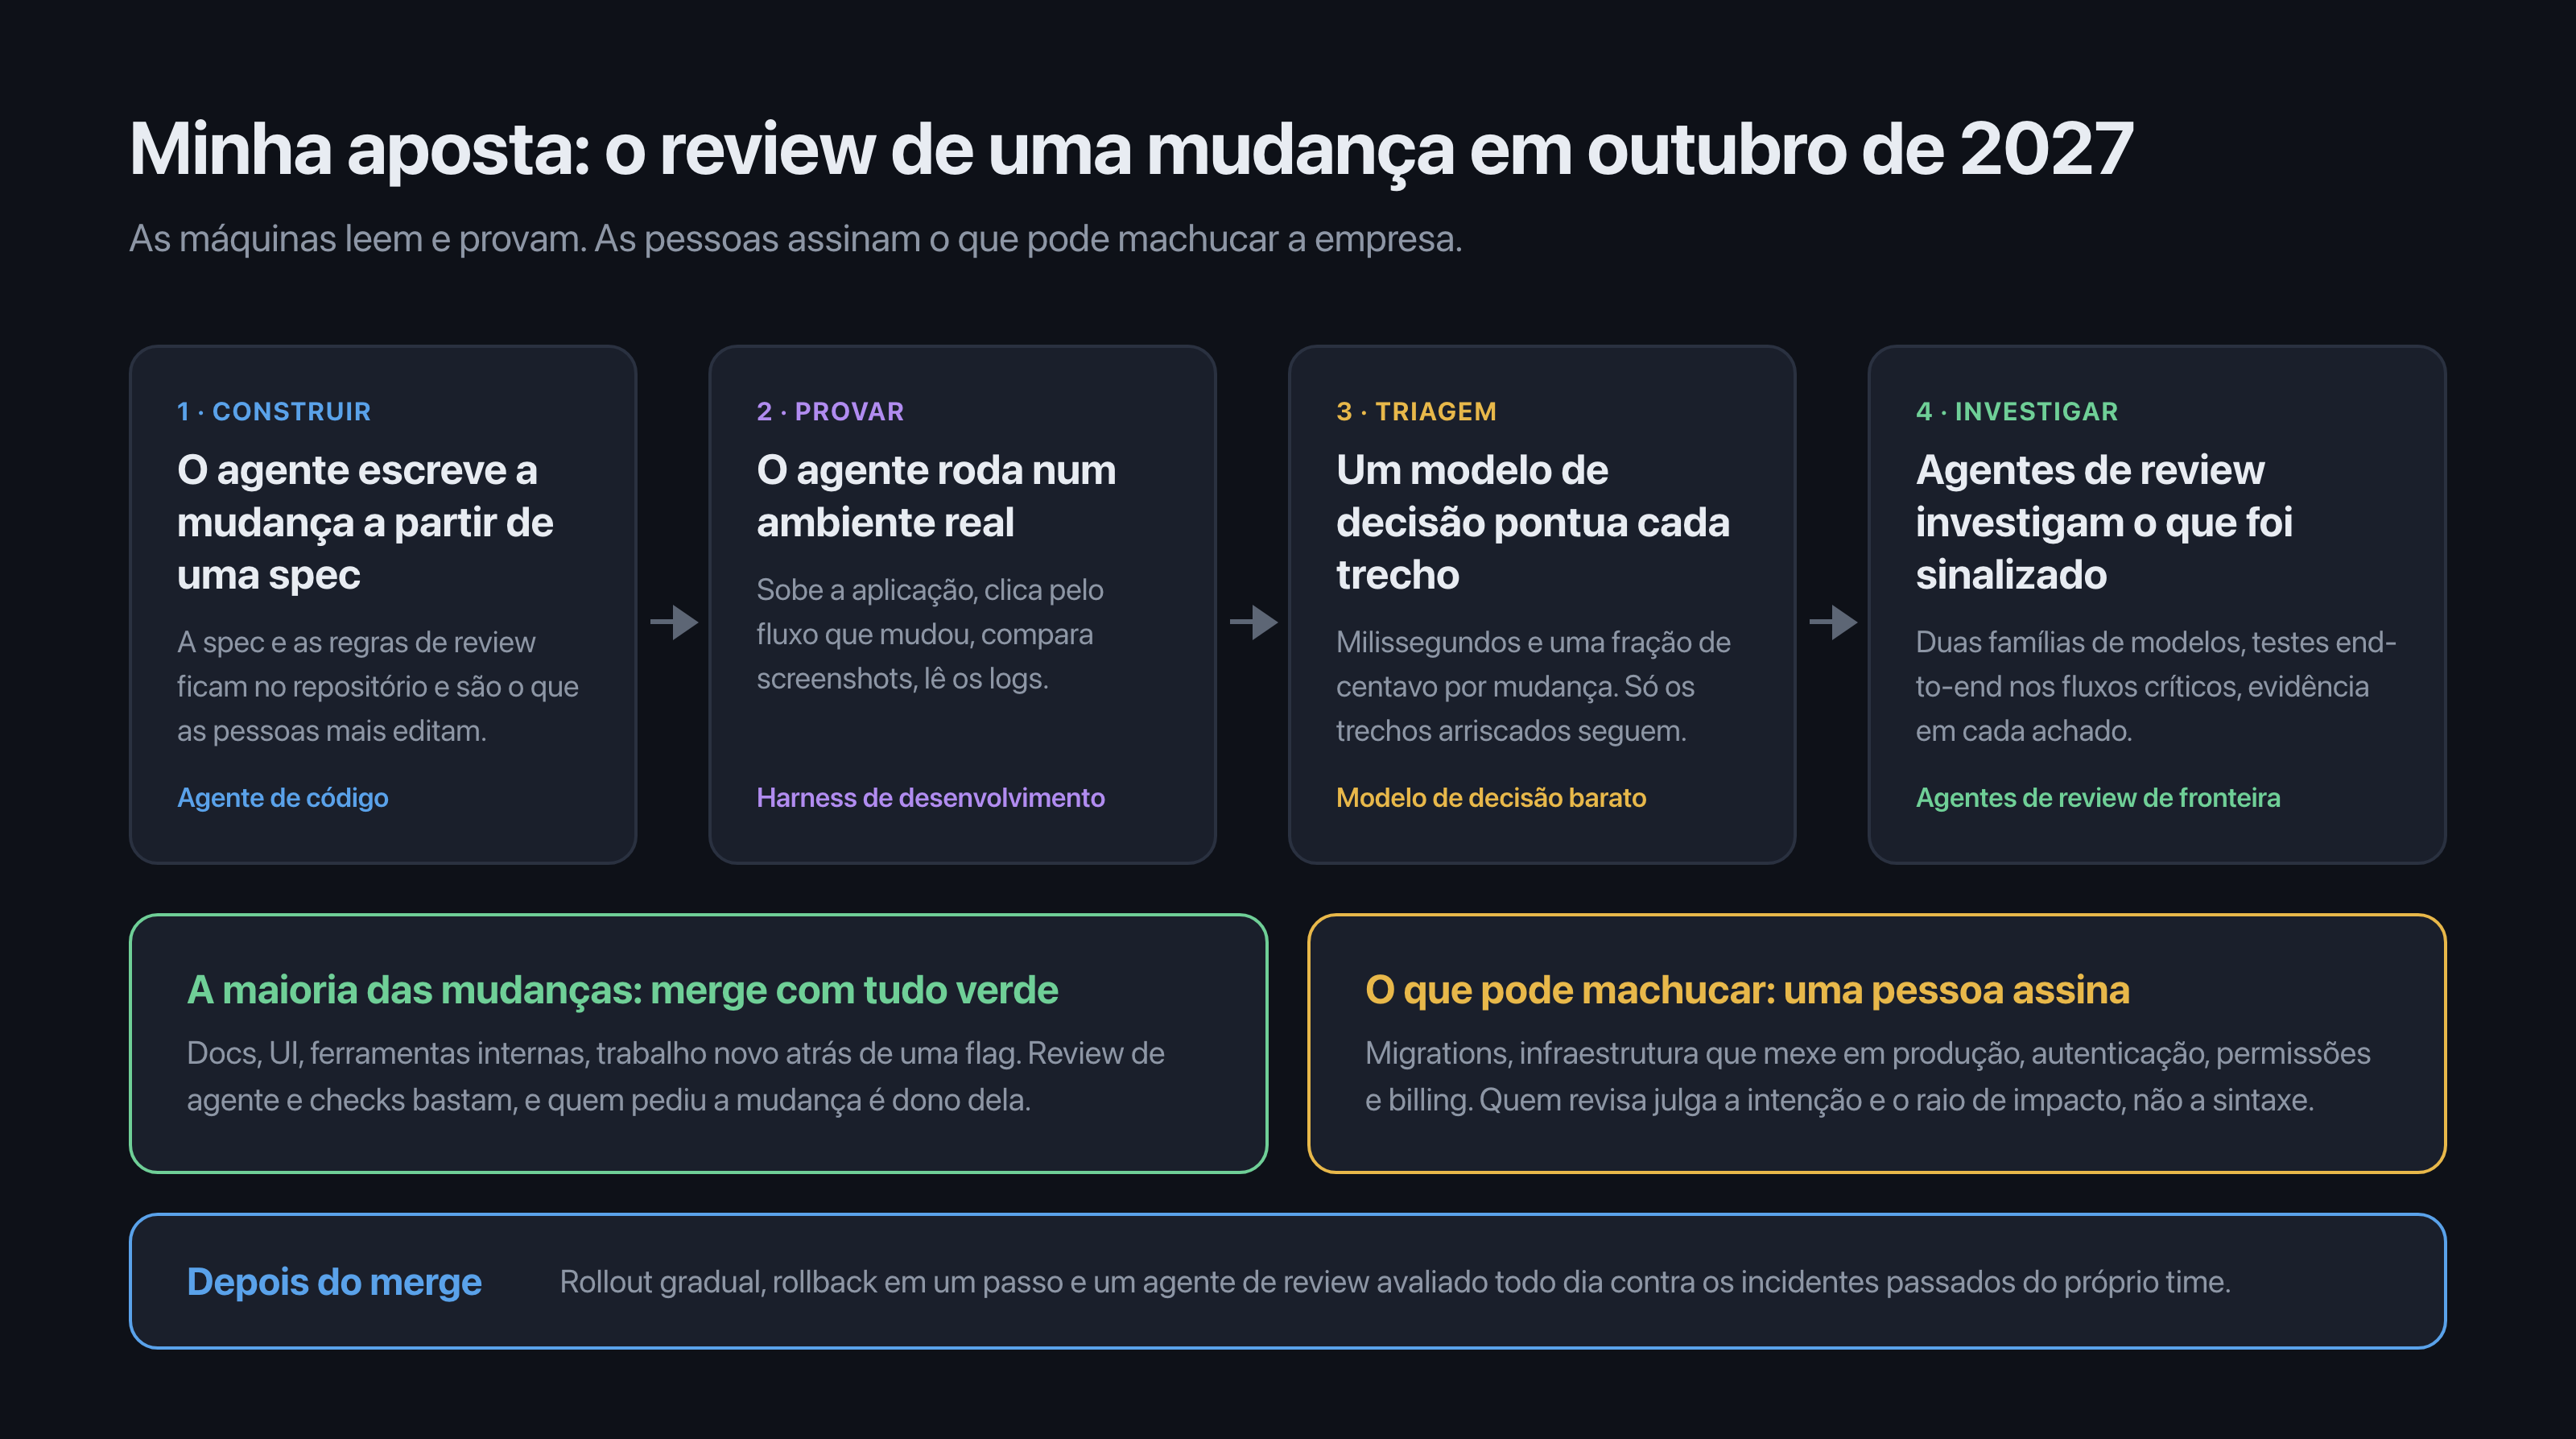
2. O review sai da leitura de diffs e vai para a prova de comportamento. Os agentes de código ganham harnesses de desenvolvimento de verdade: sobem o ambiente, clicam pelo fluxo que mudaram, comparam screenshots e leem os logs. Muitos engenheiros da Anthropic já rodam uma skill que checa o comportamento de ponta a ponta antes de abrir um pull request. Antes de produção, um agente de review rigoroso faz o mesmo num ambiente real para cada fluxo crítico. Ler o diff vira o primeiro filtro, o mais barato, e o que o revisor publica é um run com falha que você consegue reproduzir.
3. O código passa a ser escrito para máquinas checarem. Esta é a aposta em que tenho menos certeza. O DHH já vive uma versão dela com um backend em Rust que ele não lê, escolhido pela CPU e pela memória que economiza. Muito do que acrescentamos às linguagens nas últimas décadas existe para as pessoas lerem e escreverem código com conforto, e o Ruby é o caso mais claro de pagar por isso em performance. Quando as pessoas param de ler a maior parte do código, acho que essa troca se inverte. O código chega mais perto da máquina, protegido por tipos mais fortes, invariantes e contratos que um compilador ou um agente consegue checar. As evidências até agora dizem que isso acontece por linguagens rigorosas que já existem. Os agentes ainda são mais baratos e mais confiáveis nas linguagens que mais viram no treino, e precisam de nomes com significado tanto quanto nós. Tirar os nomes piora muito o quanto os modelos entendem para que serve um código, e um experimento que comprimiu logs para um agente cortou 17% dos tokens de entrada e aumentou em 67% o custo total da sessão, porque o modelo gastou a economia decifrando os logs. Então eu só aposto pela metade em linguagens novas feitas para agentes. Se aparecer uma, imagino que ela vai ser rigorosa e difícil de ler para as pessoas.
4. Modelos de decisão baratos leem cada linha. Os modelos de fronteira são lentos e caros demais para ler com atenção total cada linha de cada mudança. Uma nova classe de modelos que devolvem decisões tipadas e calibradas em vez de texto, como o Jev da TypeSafe, poderia pontuar o risco de cada trecho em bem menos de um segundo e mandar só os arriscados para o revisor caro. O review vira um pipeline: um modelo rápido faz a triagem, um modelo de fronteira investiga, uma pessoa assina. O Jev leva o nome de William Stanley Jevons, cujo paradoxo descreve este post inteiro: quando o código fica mais barato, a gente escreve muito mais código, e a carga de review cresce junto.
5. O review humano encolhe para o que pode machucar você. Migrations, código de infraestrutura que mexe em produção, autenticação, permissões e billing vão continuar com um revisor humano. A maioria das outras mudanças entra com review de agente e checks verdes, do jeito que as faixas de risco da Anthropic já funcionam. O trabalho de quem revisa passa a ser julgar a intenção e o raio de impacto, que é a parte do review que a gente sempre esteve ocupado demais para fazer bem. O que me preocupa é de onde esses revisores vão sair. A parcela de juniores nas contratações técnicas da Anthropic caiu de 27% para 9%, e eu não sei quem vai ser o sênior que assina a migration em 2030 se ninguém contratar juniores agora.
6. O compliance vai tornar essa assinatura humana obrigatória. Os auditores já perguntam quem aprovou uma mudança em produção. O regulamento DORA da União Europeia para serviços financeiros (o Digital Operational Resilience Act, que não tem nada a ver com a pesquisa DORA do Google) vai além e exige que a função que aprova uma mudança seja independente das que pedem e implementam a mudança. O PCI DSS exige que código revisado manualmente seja checado por alguém que não seja o autor e aprovado pela gestão. O SOC 2 exige que as mudanças sejam autorizadas e aprovadas, mas não diz quem aprova, e é exatamente por isso que acho que as empresas vão escrever políticas por faixa de risco dizendo quais mudanças precisam de uma pessoa, e essa lista vai se parecer muito com a aposta 5. A nova Diretiva de Responsabilidade por Produtos da União Europeia, que trata software como produto e precisa virar lei nos países até dezembro, é mais um motivo para manter uma pessoa com nome e sobrenome nas mudanças mais arriscadas. A regra da Anthropic já diz isso. Eu trabalho com compliance, e esta é a aposta em que tenho mais confiança.
7. Specs e regras de review viram o que a gente revisa. Nossas regras de review ficam no repositório junto com o código e valem a partir do pull request que as muda, e nossas specs descrevem o que cada módulo precisa fazer. Quando os agentes escrevem o código, o lugar em que as pessoas mais agregam valor é o contrato: o que este módulo promete, o que conta como problema bloqueante aqui. As specs também são onde a arquitetura é decidida. Cada pull request pode parecer ótimo enquanto a arquitetura apodrece, e nenhum review por mudança, de pessoa ou de agente, vai ver isso, então alguém precisa ser dono de como o sistema está estruturado ao longo do tempo. Espero mais tempo de review em specs e regras do que em código.
8. Os revisores passam a ser testados como software, e o rollback ganha da leitura. Todo time sério vai rodar seu agente de review contra um conjunto montado a partir dos próprios incidentes passados, todo dia, do jeito que a Anthropic faz. E os times vão investir mais em perceber e reverter rápido do que em ler mais antes do merge, porque a partir de certa velocidade de mudança, detectar e fazer rollback é a rede de segurança mais barata. A Anthropic diz que a peça que ainda não construiu é um circuit breaker que aperta as regras de aprovação automaticamente quando os reverts ou incidentes sobem. Acho que isso também vira padrão.
Como vou me avaliar
| Aposta | Confiança | O que me diria que eu errei |
|---|---|---|
| 1. As pessoas param de digitar código, e continuam donas dele | Alta | A maior parte do código de produção em times fortes ainda é digitada à mão, ou os postmortems passam a culpar “o agente” em vez de quem fez o merge da mudança |
| 2. O review vai para a prova de comportamento | Média | Fora das maiores empresas, os agentes de review ainda só leem diffs |
| 3. Código escrito para máquinas checarem | Baixa | Linguagens rigorosas e compiladas não ganham espaço em projetos novos |
| 4. Modelos de decisão baratos leem cada linha | Média | Os modelos de fronteira ficam baratos o bastante para ler tudo, ou os erros da triagem fazem os times voltarem a ler tudo |
| 5. O review humano encolhe para o que pode machucar | Alta | A carga de review cresce mais que os revisores e as pessoas voltam a ler a maioria das mudanças |
| 6. O compliance torna a assinatura humana obrigatória | Muito alta | Auditores e reguladores aceitam a aprovação de um agente como o controle para mudanças em produção |
| 7. Specs e regras viram o que a gente revisa | Média | Os times continuam gastando a maior parte do tempo de review em diffs |
| 8. Revisores testados contra incidentes, rollback em vez de leitura | Média | Avaliar revisores com incidentes continua sendo coisa de empresa grande |
Se você roda um agente de review, ou tem certeza de que eu estou errado em alguma dessas apostas, quero muito ouvir. Topo ser convencido do contrário em qualquer uma delas, menos talvez na de compliance.